
Como juntar dados de duas fontes com o Merge do n8n
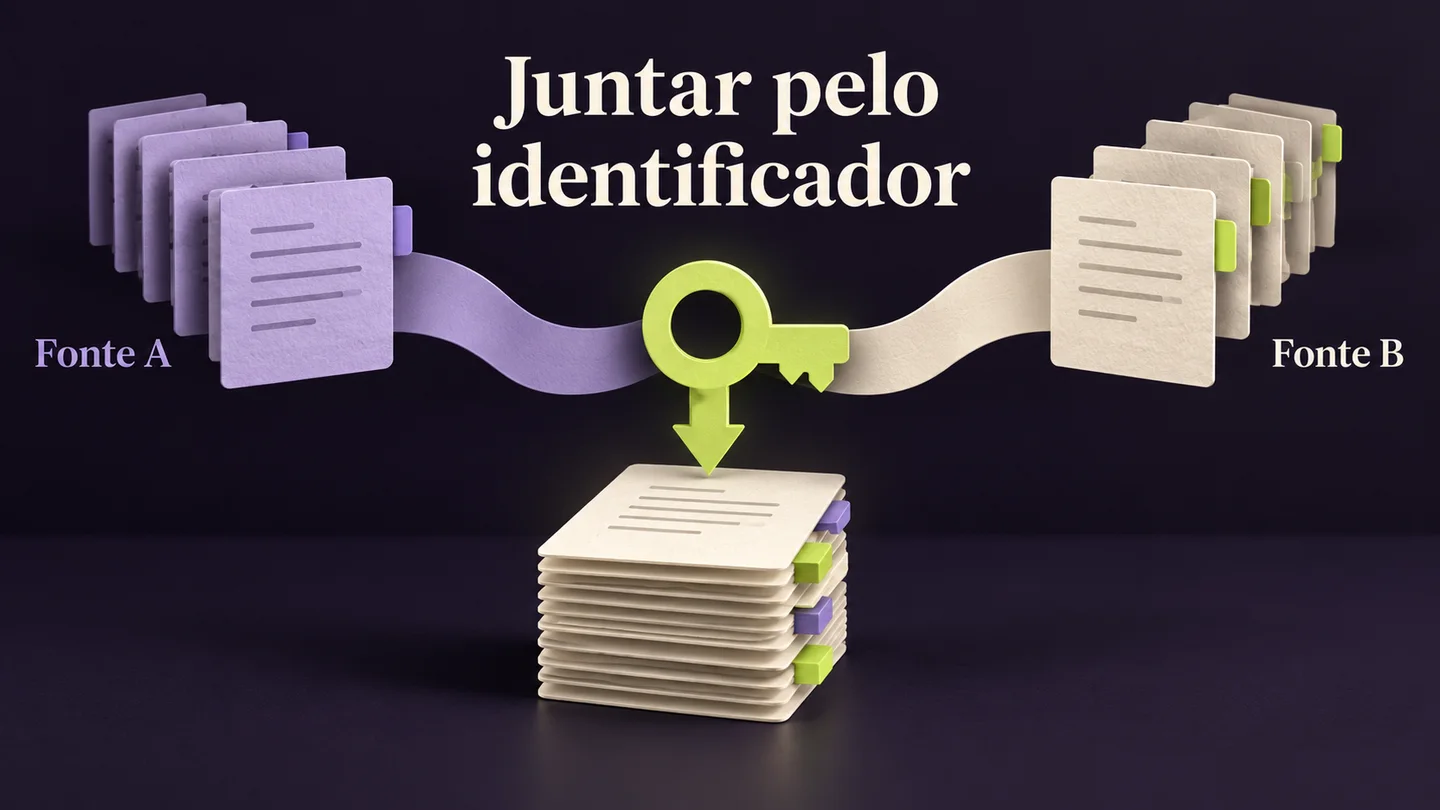
Para juntar dados de duas fontes com o Merge do n8n, define primeiro a relação entre os registos e o que deve acontecer quando não existe correspondência. Usa um identificador comum, prepara uma amostra pequena e confere a saída. A configuração certa depende de quereres acrescentar listas ou combinar informação sobre a mesma entidade.
Define o resultado antes de ligares as entradas
Escreve o que cada registo final deve representar e quais os dados que precisa de conservar. Um pedido pode receber informação do cliente, uma tarefa pode receber contexto da reunião e um produto pode receber dados de stock. Esta definição ajuda a escolher a relação correta e a perceber quando uma junção produziu um resultado enganador.
Vamos usar um exercício fictício com pedidos de orçamento e uma lista de clientes. A primeira fonte contém o identificador do pedido, o identificador do cliente e o serviço solicitado. A segunda contém o identificador do cliente e a designação usada pela equipa. Pretendemos acrescentar essa designação aos pedidos, mantendo os que ainda não têm correspondência.
O resultado esperado é um registo por pedido, desde que exista no máximo uma ficha correspondente para cada cliente. Um pedido sem ficha deve continuar visível para revisão. Não vamos enviar emails, criar oportunidades comerciais ou alterar dados num serviço externo durante este exercício.
Esta escolha é uma regra do cenário, não uma obrigação para todas as automações. Noutro processo, podes querer apenas os pedidos com correspondência confirmada. O importante é decidir isso antes de olhar para uma tabela final aparentemente completa e assumir que nenhum registo desapareceu.
Descreve também a ação seguinte. Se a equipa precisa de identificar pedidos incompletos, perder esses registos na junção prejudica o processo. Se precisa de uma lista de casos prontos para análise, a separação dos restantes deve ser intencional e acompanhada por um destino de revisão.
Identifica a chave que relaciona as duas fontes
Escolhe um campo que represente a mesma entidade nos dois lados e confirma o seu significado. Um identificador de cliente pode relacionar pedidos com fichas de clientes; a posição numa lista não oferece essa garantia. Verifica ainda o tipo, a origem e as situações em que o campo pode estar ausente, repetido ou desatualizado.
No exercício, vamos usar cliente_id. O pedido P101 pertence a C1, P102 pertence a C2 e P103 pertence a C3. A lista de clientes tem C2 e C1, por esta ordem. A mudança de ordem é deliberada: permite verificar se a combinação segue a identidade e não a posição dos registos.
Se usasses simplesmente o primeiro pedido com o primeiro cliente, P101 receberia os dados de C2. O resultado poderia continuar legível e sem erro técnico, mas estaria errado. Este é um dos motivos para conferir uma amostra pelo significado dos campos, em vez de avaliar apenas se o nó terminou a execução.
Nomes e designações podem mudar ou repetir-se. Usa-os como chave apenas quando o processo realmente garante a correspondência necessária. Não elimines espaços, zeros ou diferenças de maiúsculas sem perceber se fazem parte da identidade. Uma transformação aparentemente inofensiva pode juntar entidades que deveriam continuar separadas.
O guia para organizar dados em JSON antes de os enviar à IA ajuda a preparar nomes e tipos de campos. Mesmo quando esta junção não usa IA, a clareza das entradas continua a determinar se consegues interpretar e verificar a saída.
Prepara uma amostra pequena e legível
Cria dados fictícios que incluam correspondências, uma ausência e uma ordem diferente entre as fontes. Mantém apenas os campos necessários para compreender a relação. Uma amostra pequena permite prever o resultado à mão e torna mais fácil localizar uma configuração errada antes de envolver dados reais, integrações ou ações que produzam efeitos fora do workflow.
A tabela seguinte descreve os dados do exercício. A indicação “não aplicável” assinala campos que não pertencem àquela fonte. Esses textos são explicações da tabela, não valores que devas acrescentar aos registos do workflow.
| Fonte | pedido_id | cliente_id | Informação adicional |
|---|---|---|---|
| Pedidos | P101 | C1 | servico: Revisão de página |
| Pedidos | P102 | C2 | servico: Organização de conteúdos |
| Pedidos | P103 | C3 | servico: Preparação de formulário |
| Clientes | não aplicável | C2 | designacao_cliente: Projeto Beta |
| Clientes | não aplicável | C1 | designacao_cliente: Projeto Alfa |
Segundo a documentação da estrutura de dados do n8n, os dados circulam entre nós como itens. Confirma que tens três itens na entrada dos pedidos e dois na entrada dos clientes. Uma lista guardada dentro de um único campo pode precisar de preparação antes de representar itens separados.
Se esse for o teu caso, consulta o guia sobre separar listas em tarefas com o Split Out. Aqui, parte das duas entradas já organizadas. Mantém os nomes dos campos visíveis e evita acrescentar campos com o mesmo nome e significados diferentes durante a primeira experiência.
Podes preparar amostras com os nós Code ou Edit Fields, conforme a documentação de dados de teste do n8n. Os dados fixados servem o desenvolvimento e não são usados nas execuções de produção. Um teste com amostras não confirma que a origem real está a fornecer a informação esperada.
Configura a combinação pelo campo comum
Liga os pedidos à primeira entrada e os clientes à segunda. Seleciona a combinação por correspondência de campos e indica o identificador comum. Depois, escolhe a regra de conservação dos registos. Confere cada opção no contexto da versão do nó que tens instalada, para que a configuração corresponda ao resultado que definiste para o exercício.
Na documentação do Merge, a combinação por identidade usa Mode: Combine e Combine By: Matching Fields. Define cliente_id em Fields to Match. Para preservar todos os pedidos e acrescentar os clientes encontrados, seleciona Output Type: Enrich Input 1.
O modo Append coloca os itens das entradas numa sequência; não faz esta correspondência por cliente. A combinação por Position associa os itens pela ordem. Para este exemplo, essas escolhas não representam a relação pretendida entre pedidos e fichas.
Confirma visualmente qual ramo chega a Input 1 e qual chega a Input 2. Se os trocares sem rever a regra, podes passar a conservar a lista de clientes em vez da lista de pedidos. Dá nomes claros aos nós anteriores para reduzir essa ambiguidade quando retomares o workflow.
Executa a amostra e abre os dados de saída. Procura P101 e confirma que recebeu Projeto Alfa; procura P102 e confirma Projeto Beta. P103 deve continuar presente sem uma designação de cliente acrescentada pela correspondência. Este é o resultado previsto para os dados propostos, não o relato de uma execução real do n8n.
Confere quantidades e registos sem correspondência
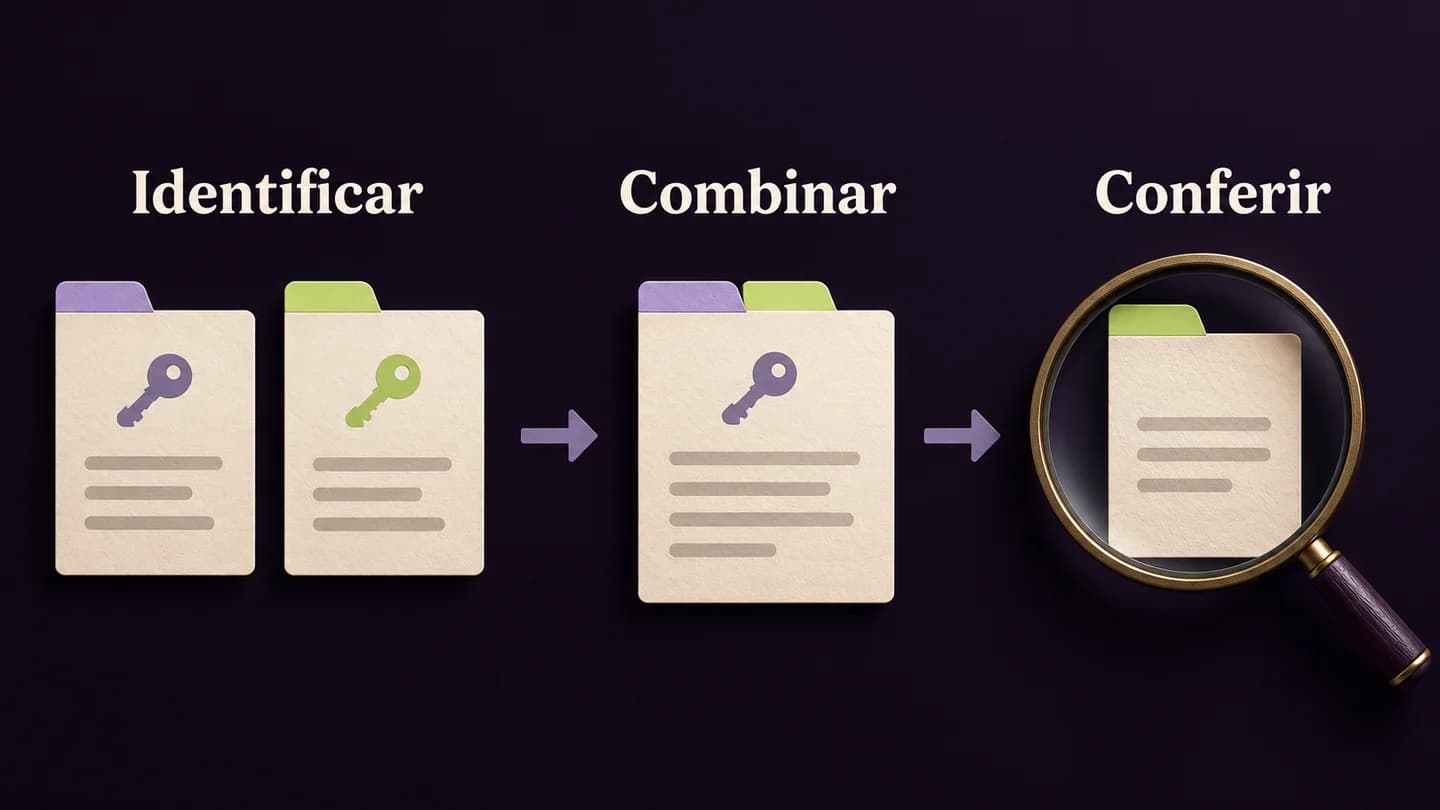
Compara a saída com as entradas e identifica o motivo de cada registo conservado, combinado ou excluído. Uma contagem correta ajuda, mas não basta para provar uma junção correta. Verifica também os identificadores e os valores acrescentados, sobretudo nos casos em que falta informação ou em que uma regra pode retirar registos do percurso principal.
No exemplo, esperas três pedidos no resultado e duas designações acrescentadas. P103 precisa de revisão porque C3 não aparece na lista de clientes. Não preenchas a designação com o nome de outro cliente nem interpretes a ausência como prova de que o pedido é inválido. Pode ser apenas uma fonte incompleta.
Se o objetivo fosse conservar apenas correspondências, a opção Keep Matches produziria dois pedidos neste cenário. O código oficial da combinação por campos distingue essa saída das opções que preservam itens sem correspondência. Escolhe a regra pelo processo e documenta o que acontece aos restantes.
Separa “sem correspondência” de “campo em falta”. Um pedido pode indicar C3 corretamente e a ficha não estar disponível; outro pode nem ter cliente_id. São problemas diferentes e podem exigir ações diferentes. Mantém essa distinção no registo de revisão para não transformar todas as falhas numa mensagem genérica.
Define quem resolve a pendência e como o pedido volta ao processo depois da correção. Mesmo num exercício sem destino externo, podes acrescentar uma lista de casos a conferir. Isso torna explícito que a automação organizou informação, mas não decidiu por si a validade comercial de cada pedido.
Trata duplicados e campos com o mesmo nome
Antes de aumentares o volume, verifica se a chave pode encontrar mais do que uma correspondência e se existem campos repetidos com valores diferentes. Estes casos podem multiplicar registos ou substituir informação. A decisão deve vir do significado dos dados e das regras do processo, para que a junção não esconda um problema na fonte.
Imagina que a lista de clientes contém duas fichas com cliente_id C1: Projeto Alfa e Projeto Alfa Antigo. P101 passa a ter duas correspondências possíveis. A pergunta a resolver é qual ficha representa o cliente atual, ou se a chave escolhida está incompleta. Escolher arbitrariamente uma delas não corrige essa dúvida.
O código oficial do Merge disponibiliza Multiple Matches, com opções para incluir todas as correspondências ou apenas a primeira. No exercício, a opção de todas pode produzir dois resultados para P101. O método de correspondência e junção permite conferir esse comportamento. Revê a identidade antes de usar a primeira correspondência como solução.
Considera também um campo chamado estado. Na fonte dos pedidos, pode significar “por analisar”; na fonte dos clientes, pode significar “ativo”. São conceitos diferentes, apesar do nome igual. Uma preparação mais clara usa estado_pedido e estado_cliente, conservando os dois significados sem depender de uma substituição implícita.
As opções de Clash Handling permitem definir como lidar com conflitos. Ainda assim, a melhor regra depende do teu caso. Se duas fontes discordam sobre o mesmo facto, identifica a autoridade e a data de cada uma. Uma prioridade técnica entre entradas não prova que o valor escolhido é o correto para o negócio.
Testa os casos que podem alterar a relação
Depois de conferires a amostra inicial, muda uma condição de cada vez e observa o efeito. Testa ordem, ausência de chave, duplicados e tipos diferentes. Regista o resultado esperado antes de executar. Esta disciplina ajuda a perceber se a alteração corrigiu o problema ou se apenas produziu uma saída diferente que ainda precisa de explicação.
| Alteração na amostra | O que deves conferir |
|---|---|
| Trocar a ordem dos clientes | P101 continua associado a C1 |
| Retirar cliente_id de P102 | A ausência fica identificada para revisão |
| Acrescentar outra ficha C1 | A multiplicidade é detetada e explicada |
| Usar tipos diferentes na chave | A regra de comparação é conhecida e testada |
| Esvaziar uma das fontes | O percurso e a saída observada correspondem ao objetivo |
Confere tipos antes de recorrer a comparações tolerantes. Uma chave numérica e uma chave textual podem parecer iguais na tabela, mas representar valores distintos no processamento. Define a normalização com base no contrato da fonte e preserva os valores originais quando precisas de investigar a transformação.
O Merge tem uma opção Fuzzy Compare para tolerar certas diferenças de tipo. Confirma o seu âmbito nas definições oficiais das opções. Não a uses como substituto de uma regra de identidade nem assumas que corrige nomes parecidos, dados incompletos ou fichas duplicadas.
Nos casos com uma fonte vazia, observa também se o ramo chegou a executar e se o nó recebeu os dados esperados. Uma lista sem itens, uma consulta falhada e um ramo que não correu são situações diferentes. Regista a execução que viste, sem deduzir o comportamento apenas pelo desenho do editor.
Confirma o percurso completo antes de usar dados reais
Quando a junção estiver revista, confere as etapas anteriores e posteriores com uma amostra autorizada. Verifica de onde vieram os dados, que transformação receberam e como serão usados. A aprovação do Merge cobre a relação entre entradas; o processo completo ainda precisa de demonstrar que lê a origem certa e produz o efeito pretendido no destino.
Se a etapa seguinte cria um registo por pedido, confirma que recebe o identificador do pedido e não apenas o do cliente. Dois pedidos do mesmo cliente continuam a ser dois pedidos. A chave usada para enriquecer informação pode ser diferente da chave necessária para evitar duplicações no destino.
Ao mapear campos posteriores, consulta o guia sobre expressões no n8n sem perder campos importantes. Confere o item efetivamente recebido e a relação com os nós anteriores. Um campo visível numa execução antiga não prova que existe na configuração atual.
Guarda a amostra, a configuração e os resultados observados. Antes de ativar ações externas, confirma os destinatários, o âmbito autorizado e o tratamento de repetições. O exercício fica concluído quando consegues explicar a origem de cada valor e o destino dos casos que a junção não resolveu.
Como podes aprender isto no Laboratório da IA
No Laboratório da IA, podes praticar a organização de dados e a construção de automações com exemplos ligados ao teu trabalho. As aulas semanais e os Zooms de acompanhamento semanais ajudam-te a perceber entradas, transformações e resultados. Leva uma amostra pequena e uma dúvida concreta, para trabalhares a configuração e a revisão do teu processo.
Começa com duas fontes fictícias e define o resultado antes de abrir o nó. Depois, testa uma correspondência, uma ausência e um duplicado. Aprende a interpretar o que o workflow produziu antes de acrescentar envios ou escritas, para que a próxima etapa receba dados que consegues justificar.
Referências e data de revisão
Este guia foi revisto em 14 de outubro de 2026 com base em materiais do Laboratório da IA sobre identidade de registos, listas e diagnóstico de workflows. A configuração do Merge foi conferida na documentação e no código oficiais. Os pedidos e clientes apresentados são fictícios; não se afirma execução de uma integração real.
Aprende a construir isto no Lab.
Trabalha o processo com aulas, materiais e acompanhamento. Leva o que estás a construir e esclarece as dúvidas da tua implementação.
- Escolher a identidade e a regra de conservação dos registos.
- Conferir correspondências, ausências, duplicados e campos em conflito.
- Praticar automações nas aulas e Zooms semanais do Laboratório.
Aulas semanais para aprender e aplicar. Zooms de acompanhamento semanais para esclarecer dúvidas. Replay e materiais para retomar o trabalho ao teu ritmo.
Entrar no Laboratório da IA