
Qual é o melhor modelo de IA para usar hoje? Escolhe pela tarefa
O melhor modelo de IA para ti é o que resolve a tarefa com qualidade verificável, dentro do tempo e dos limites que tens. Para trabalho complexo, compara candidatos de maior capacidade; para tarefas claras e repetidas, testa opções mais eficientes. Confirma também as ferramentas e o acesso disponíveis na aplicação.
Se procuras um nome para começar, há candidatos concretos mais abaixo. A escolha muda bastante entre rever um anúncio, analisar documentos contraditórios, construir uma aplicação ou classificar centenas de pedidos. Usar sempre o mesmo modelo pode ser conveniente, mas vale a pena perceber onde essa escolha funciona e onde começa a exigir demasiadas correções.
Este guia foi verificado em 13 de outubro de 2026. Os nomes e posicionamentos vêm da documentação oficial consultada nessa data; as recomendações de teste são uma aplicação editorial desses dados aos métodos trabalhados no Laboratório da IA. Não apresentamos uma classificação obtida por executar todos os modelos nos mesmos testes, nem resultados que não foram medidos.
Vamos usar exemplos de escrita, pesquisa, documentos, código e tarefas repetidas. Em cada um, a pergunta será a mesma: o que precisa de acontecer para considerares a saída útil? Essa definição ajuda-te a escolher dois candidatos relevantes e a comparar trabalho concluído, em vez de acumular opiniões sobre qual parece mais inteligente.
Que modelos fazem sentido testar hoje?
Para projetos complexos, considera GPT-6.1 Sol, Claude Opus 5.5 ou Gemini 4 Argon, conforme o ambiente a que tens acesso. Para exigência adicional, avalia os modelos de maior capacidade documentada; para trabalho repetido, testa opções eficientes. Estas são listas de candidatos por perfil de tarefa, não equivalências de desempenho comprovadas.
A OpenAI posiciona GPT-6 Astra para o trabalho mais exigente, GPT-6.1 Sol para equilibrar capacidade, velocidade e custo, e GPT-6 Luna para tarefas delimitadas com maior volume. A distinção está no guia oficial da família GPT-6. Usa esse posicionamento para escolher um ponto de partida e confirma depois o resultado com os teus próprios exemplos.
Na Anthropic, o catálogo atual inclui Claude Fable 5.1, Opus 5.5, Sonnet 5.5 e Haiku 5.5. O fornecedor associa Fable a raciocínio exigente e trabalho prolongado, Opus a projetos complexos, Sonnet ao equilíbrio entre velocidade e capacidade e Haiku a volume e baixa latência. Consulta o catálogo oficial Claude para verificar as versões em vigor.
Na Google, Gemini 4 Argon é apresentado como modelo de raciocínio para problemas complexos, enquanto Gemini 3.8 Flash combina trabalho exigente com o perfil de velocidade e eficiência da família Flash. Estas descrições constam das páginas de Gemini 4 Argon e Gemini 3.8 Flash. A existência no catálogo API não confirma que a tua aplicação de conversa mostre o mesmo seletor.
| Necessidade inicial | Candidatos a considerar | O que deve decidir o teste |
|---|---|---|
| Projeto complexo com várias etapas | GPT-6.1 Sol, Claude Opus 5.5, Gemini 4 Argon | Concluir o percurso e preservar requisitos |
| Problema especialmente exigente | GPT-6 Astra, Claude Fable 5.1, Gemini 4 Argon | Resolver as dificuldades que os outros deixaram |
| Trabalho frequente com atenção ao tempo | GPT-6.1 Sol, Claude Sonnet 5.5, Gemini 3.8 Flash | Qualidade aceite com menos espera e revisão |
| Extração ou classificação delimitada | GPT-6 Luna, Claude Haiku 5.5 | Consistência nos casos normais e nas exceções |
Não precisas de testar todos. Escolhe o candidato disponível no ambiente que já utilizas e uma alternativa pertinente quando houver uma razão concreta para comparar. A tabela organiza perfis anunciados pelos fornecedores; não estabelece que os modelos da mesma linha tenham o mesmo preço, velocidade, ferramentas ou qualidade em português.
Distingue modelo, aplicação e ferramentas disponíveis
Confirma o nome do modelo, a aplicação onde o utilizas, as ferramentas ativas e as condições da tua conta. O mesmo nome de família pode aparecer em ambientes com capacidades diferentes. Uma comparação só fica compreensível quando sabes se a resposta usou ficheiros, pesquisa, execução de código ou outras operações.
Uma aplicação pode permitir anexar documentos, consultar páginas ou editar ficheiros, enquanto outra oferece apenas uma conversa. Essas diferenças afetam o trabalho que consegues concluir, mesmo que os modelos tenham capacidades semelhantes. Para analisar uma folha de cálculo, por exemplo, importa saber se o ambiente consegue abrir o ficheiro e executar cálculos verificáveis.
A documentação da OpenAI distingue explicitamente a disponibilidade em Work e Codex da experiência Chat: GPT-6.1 Sol, GPT-6 Sol e GPT-6 Luna estão documentados para Work e Codex, não para Chat. O acesso depende ainda do plano, cliente e disponibilização da funcionalidade. Confirma a situação na página oficial de modelos e disponibilidade, sem inferir acesso apenas porque tens uma conta ChatGPT.
Na prática, regista a comparação com uma descrição como «modelo selecionado, aplicação usada, pesquisa ativa e ficheiros fornecidos». Se um candidato recebeu o documento completo e outro apenas um resumo, já alteraste uma condição importante. O resultado pode continuar a ser interessante, mas não permite atribuir toda a diferença ao modelo.
O mesmo cuidado aplica-se a ações. Um assistente pode explicar como criar uma tarefa sem ter acesso ao sistema onde ela deve ficar. Outro pode ter uma integração que executa a operação. Avalia separadamente a qualidade da explicação e a confirmação de que a ação foi realmente concluída no destino certo.
Se a tua dúvida principal estiver na escolha da aplicação, usa também a comparação entre ChatGPT, Claude e Gemini para o trabalho. Aqui, o foco é escolher a capacidade adequada dentro de um percurso que já identificaste. A aplicação e as integrações podem pesar tanto como o modelo na utilidade final.
Para escrever, compara fidelidade e trabalho de revisão
Na escrita, começa pelo modelo disponível que consegue seguir o briefing, preservar os factos e respeitar a tua voz. Compara-o com uma alternativa usando as mesmas referências e o mesmo objetivo. Avalia as correções necessárias e a adequação ao destinatário, sem confundir uma frase mais chamativa com um texto comercialmente melhor.
Imagina que precisas de um email sobre uma nova formação. Fornece a mesma oferta, o mesmo público, os mesmos exemplos de voz e a mesma ação pretendida aos dois candidatos. Antes de ler, define erros que tornam a versão inutilizável: inventar uma data, acrescentar um resultado garantido ou alterar o que está incluído na formação.
Depois observa escolhas menos binárias. O texto responde à dúvida principal? Explica o suficiente para a pessoa decidir? Usa o tratamento e o vocabulário adequados? Um modelo pode produzir uma abertura que aprecias e, ainda assim, exigir mais trabalho no corpo do email do que outro cuja primeira frase parece menos impressionante.
Não precisas de escolher um vencedor permanente para toda a escrita. Um modelo pode funcionar bem para adaptar um texto aprovado e outro para organizar um argumento novo com várias restrições. Regista o tipo de tarefa em que observaste a diferença, para não transformar uma preferência local numa regra que aplicas a tudo.
Se ainda não tens referências claras, começa pelo guia para definir a tua voz de escrita com IA. Sem esse contexto, podes acabar por premiar a interpretação do modelo que mais se aproxima do teu gosto naquele momento. Com referências, consegues explicar por que motivo uma versão está mais alinhada com a marca.
Para este tipo de trabalho, eu começaria por um candidato equilibrado disponível no teu ambiente e só aumentaria a capacidade quando as falhas persistissem com um briefing claro. Esta é uma recomendação de processo, não uma garantia sobre um modelo específico. A escolha deve reduzir o esforço para chegar a uma peça correta e utilizável.
Para pesquisar, verifica se houve pesquisa e suporte real
Quando a pergunta depende de informação atual, escolhe um ambiente com pesquisa adequada e confirma que as fontes foram realmente consultadas. Abre as referências decisivas e verifica datas, contexto e apoio à afirmação. Um modelo com mais capacidade de raciocínio continua a precisar de evidência atual para responder sobre mudanças recentes.
Uma pergunta sobre o preço atual de um serviço não deve ser respondida apenas com conhecimento memorizado. O mesmo acontece com modelos disponíveis, condições de um produto ou funcionalidades que mudaram. Pede a fonte oficial e a data de consulta, e confirma que a página fala da modalidade que te interessa.
Há três verificações diferentes: o ambiente pode pesquisar, a pesquisa foi feita e a fonte sustenta a resposta. Um link apresentado no fim não demonstra automaticamente as três. Pode apontar para uma página genérica, para uma versão antiga ou para um documento que confirma apenas uma parte da conclusão.
Num teste comparativo, usa uma pergunta cuja resposta atual consigas verificar. Pede que cada candidato distinga factos encontrados, inferências e pontos não confirmados. Avalia tanto a correção como a capacidade de reconhecer uma lacuna. Uma resposta prudente e útil pode ser melhor do que uma conclusão completa construída com informação que não existe na fonte.
Para pesquisas com várias fontes contraditórias, vale a pena testar um modelo de maior capacidade e dar-lhe critérios de comparação. Explica que diferenças importam e que documentos têm prioridade para a decisão. A lista de candidatos para trabalho complexo ajuda a começar, mas a prova estará na forma como a resposta trata a contradição concreta.
Não uses o tempo de espera como sinal isolado de profundidade. Uma resposta demorada pode continuar sem abrir a fonte certa, enquanto uma consulta simples pode resolver uma dúvida rapidamente. O critério deve ser a qualidade da evidência e do raciocínio necessário para a tua pergunta, não a duração visível da geração.
Para documentos e tabelas, mede cobertura e precisão
Ao analisar documentos, define as perguntas e verifica se as respostas cobrem as passagens relevantes. Em tabelas, confere cabeçalhos, linhas, unidades e valores em falta, usando a fonte estruturada quando existe. A capacidade de aceitar muito contexto ou imagens não demonstra, por si só, que todos os elementos foram interpretados corretamente.
Um resumo de um documento curto e a análise de uma coleção extensa são tarefas diferentes. Na primeira, podes conferir rapidamente as afirmações importantes contra o original. Na segunda, precisas também de saber que ficheiros foram processados, quais falharam e como as conclusões se distribuem pelas fontes. Escolhe o ambiente e o modelo tendo essa escala em conta.
Prepara um teste com uma condição importante no início, outra no meio e uma exceção perto do fim de um documento. Pede uma resposta que use as três quando forem relevantes. Se o candidato produzir uma síntese fluente mas omitir a exceção, o resultado ajuda a identificar uma falha concreta de cobertura, em vez de uma impressão vaga sobre inteligência.
Em informação tabular, prefere o ficheiro estruturado autorizado à captura de ecrã quando ambas as opções existem. Uma imagem pode dificultar a leitura de células, cabeçalhos e separadores. Se tiveres de trabalhar com imagem, confere os pontos críticos e distingue um valor zero de uma célula vazia ou de uma falha de extração.
Para cálculos, pede um método verificável e reconcilia os totais com a origem. A escolha do modelo pode ajudar a interpretar o problema, mas a operação aritmética deve poder ser conferida. Se o ambiente executa código ou fórmulas, verifica os dados usados e o resultado, em vez de aceitar um número apenas porque vem acompanhado de uma explicação longa.
Quando o objetivo é estudar um conjunto de fontes, o guia de NotebookLM para documentos mostra como organizar perguntas, citações e exercícios. Essa organização pode ser mais importante para o teu caso do que escolher o modelo com a maior janela anunciada. O resultado útil precisa de manter ligação ao que foi realmente fornecido.
Para código e projetos, avalia a entrega completa
Na construção de software, compara a capacidade de compreender o projeto, alterar o necessário e verificar o comportamento pedido. Usa um percurso delimitado e observa os ficheiros modificados, os testes e a aplicação em funcionamento. Uma resposta com código plausível não equivale a uma alteração integrada e confirmada no teu ambiente.
Se queres corrigir um formulário, fornece os passos que provocam o erro e o resultado esperado. O teste deve verificar o caso que falhava e um percurso normal relacionado. Um candidato que explica muito bem a solução mas não consegue aplicá-la com as ferramentas disponíveis pode ser menos útil para essa tarefa do que outro integrado no projeto.
Para trabalho complexo, GPT-6.1 Sol e Claude Opus 5.5 são pontos de partida documentados nos respetivos ecossistemas; Gemini 4 Argon é outro candidato descrito pela Google para engenharia de software exigente. Essa seleção não estabelece uma ordem entre eles. Compara apenas os candidatos a que consegues dar contexto e condições de execução adequadas.
Se a primeira tentativa falhar, identifica a causa antes de mudar de modelo. Pode faltar uma dependência, um acesso ou uma decisão de produto. Nenhum aumento de capacidade resolve automaticamente uma permissão inexistente ou uma regra que ainda não foi definida. Corrigir o contexto permite perceber melhor se a limitação está no modelo ou no ambiente de trabalho.
O guia para começar um projeto com Claude Code explica como separar protótipo, validação e publicação. Esses critérios também servem para avaliar outros agentes de programação. Mede a entrega pelo comportamento que precisavas de obter e pela evidência disponível, mantendo versões recuperáveis do projeto.
Quando a tarefa envolve várias etapas e decisões difíceis, pode fazer sentido testar maior esforço de raciocínio ou um modelo mais capaz. Altera uma condição de cada vez e observa se a falha concreta melhora. Se mudares simultaneamente modelo, instruções, ferramentas e dados, será mais difícil perceber o que tornou a segunda tentativa útil.
Para tarefas repetidas, conta o custo por saída aceite
Em classificação, extração e transformação repetida, testa primeiro uma opção eficiente que cumpra critérios claros de qualidade. Inclui casos incompletos e ambíguos, e mede o trabalho de revisão necessário. Compara o consumo e o tempo por resultado aceite, distinguindo a utilização incluída numa subscrição dos custos de uma integração por API.
Imagina uma tarefa de classificar pedidos recebidos em três categorias. Um conjunto de teste pode incluir exemplos evidentes, mensagens com dois assuntos e casos que não pertencem a nenhuma categoria. Define antecipadamente quando o resultado deve ser «precisa de revisão». Obrigar o modelo a escolher sempre uma categoria pode produzir uma aparência de consistência que esconde erros.
GPT-6 Luna e Claude Haiku 5.5 são candidatos atuais para este perfil, segundo os fornecedores. A Anthropic descreve uma abordagem em que se começa pela eficiência e se aumenta a capacidade quando os testes revelam uma lacuna, no guia oficial de escolha de modelos. O critério continua a ser o desempenho no teu conjunto de casos.
Não compares apenas o preço anunciado por unidade de consumo. Uma opção pode precisar de mais tentativas, contexto adicional ou revisão humana para chegar à mesma saída aceite. Numa subscrição, os limites e modalidades de utilização também podem ser diferentes dos preços publicados para API. Regista o percurso que vais realmente utilizar antes de fazer contas.
Podes encaminhar casos ambíguos para revisão, em vez de exigir a mesma configuração para todos os pedidos. Começa por uma solução simples e observa a frequência dessas exceções. Uma arquitetura com vários modelos só se justifica quando a diferença de qualidade, utilização ou tempo compensa a complexidade adicional de a manter.
Se atingires um limite, confirma qual foi antes de alterar o processo. Pode ser um limite da conta, do modelo, do ficheiro ou da ferramenta usada. Trocar para uma API paga sem uma decisão consciente muda o custo da operação; não deve ser tratado como continuação automática de uma utilização já incluída.
Compara dois candidatos com os teus próprios exemplos
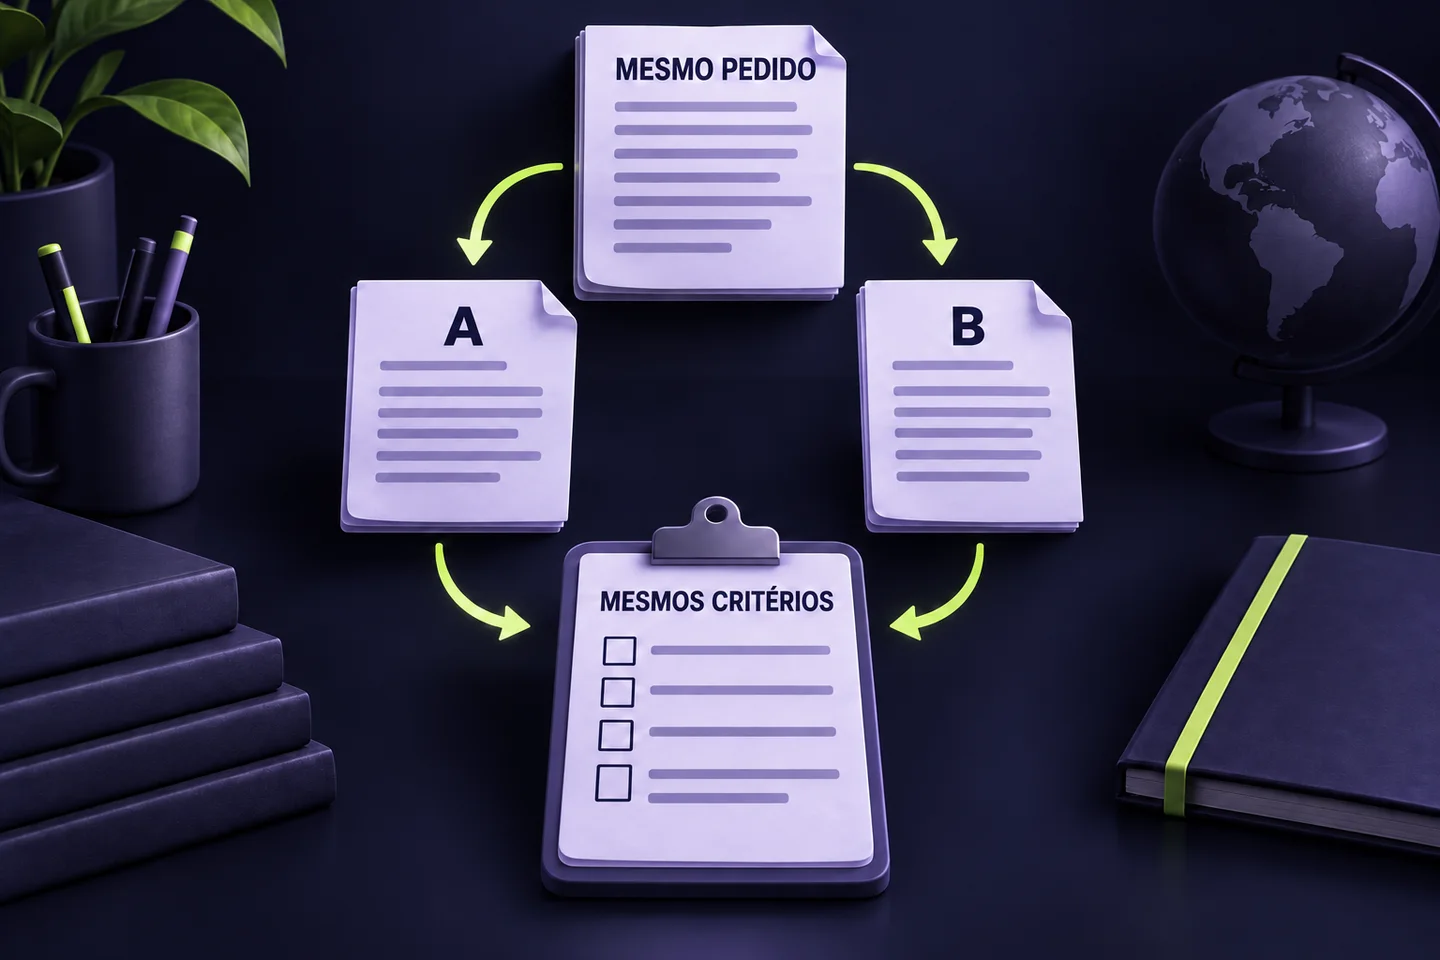
Escolhe uma pequena amostra representativa, mantém as entradas e os critérios iguais e regista a configuração de cada candidato. Avalia erros decisivos antes de preferências de estilo, incluindo o esforço de correção. Usa a comparação para escolher o próximo passo, sem apresentar um teste pequeno como classificação universal de todos os modelos.
Para começar, reúne cinco situações reais autorizadas ou exemplos sintéticos equivalentes. Inclui uma tarefa normal, uma mais difícil e uma em que falta informação. A quantidade serve apenas para tornar o exercício manejável; não transforma a amostra numa avaliação estatística robusta. O importante é que os casos representem dificuldades que encontras no trabalho.
Prepara uma grelha com resultado esperado, erro inaceitável, tempo observado e correções necessárias. Guarda também a resposta original, para não avaliares apenas a versão que já corrigiste. Se repetires uma tentativa, regista a repetição e o motivo, mantendo visível o esforço total necessário para chegar ao resultado final.
Quando conseguires, revê as saídas sem olhar primeiro para o nome do fornecedor. Isso ajuda a concentrar a avaliação no conteúdo, embora não elimine todas as preferências. Uma resposta pode revelar o estilo da ferramenta, e diferentes ambientes podem oferecer formatos distintos. Regista essas condições em vez de fingir uma neutralidade que o exercício não tem.
A comparação prática de ChatGPT, Claude e Gemini propõe ensaios de escrita, documentos e dados com critérios verificáveis. Os rankings públicos podem ajudar a reduzir a lista inicial, mas precisas de perceber que tarefa, idioma e métrica representam. Preferência de utilizadores, acerto técnico e volume de utilização medem coisas diferentes.
No fim, escreve uma decisão curta: «Para esta tarefa, com estes dados e este ambiente, vou usar este candidato; volto a comparar se surgir esta falha ou se mudar esta condição.» Assim, a escolha fica ligada ao teu trabalho e tem um motivo para ser revista. Não precisas de acompanhar todas as novidades para saber quando uma mudança pode valer a pena.
Como podes aprender isto no Laboratório da IA
No Laboratório da IA, podes trabalhar a escolha de modelos a partir das tarefas que queres resolver, com contexto, exemplos e critérios de avaliação. As aulas semanais e os Zooms de acompanhamento semanais ajudam a aplicar o método. Leva um caso concreto e compara resultados que consigas verificar.
A aprendizagem útil é perceber por que motivo uma configuração funciona no teu caso e o que precisas de mudar quando deixa de funcionar. Os nomes evoluem; a capacidade de preparar a tarefa, testar candidatos e avaliar a entrega continua a ajudar-te a tomar decisões melhores.
Aprende a construir isto no Lab.
Trabalha o processo com aulas, materiais e acompanhamento. Leva o que estás a construir e esclarece as dúvidas da tua implementação.
- Escolher candidatos pela tarefa, pelo tempo e pelos limites reais.
- Distinguir modelo, aplicação, ferramentas e disponibilidade.
- Comparar resultados com exemplos e critérios do teu trabalho.
Aulas semanais para aprender e aplicar. Zooms de acompanhamento semanais para esclarecer dúvidas. Replay e materiais para retomar o trabalho ao teu ritmo.
Entrar no Laboratório da IA