
Como receber alertas quando uma automação falha
Para receberes alertas úteis quando uma automação falha, define que situações devem ser detetadas, quem responde e que informação precisa de chegar à pessoa certa. Liga a falha a um aviso com contexto e testa a receção. Depois confirma o procedimento de recuperação, incluindo o risco de repetir ações já realizadas.
Define o que significa falhar no teu processo
Uma execução pode terminar com erro, produzir um resultado incorreto ou nem chegar a acontecer. Estas situações precisam de verificações diferentes. Começa pelo resultado esperado do processo e identifica os sinais que mostram que ele não foi cumprido, para que o alerta corresponda a um problema que alguém consegue investigar e resolver.
Vamos usar um exemplo fictício: um workflow recebe o identificador de uma reunião, consulta o resumo e prepara um rascunho de email para revisão. O resultado esperado é um rascunho associado à reunião certa, com destinatário de teste definido. O envio automático não faz parte deste exercício.
Há várias formas de o processo falhar. Pode faltar o identificador, a consulta pode ser recusada, o resumo pode pertencer a outra reunião ou a criação do rascunho pode ficar com resultado incerto. Um único aviso “automação falhou” não permite distinguir estes casos.
Define também o que é um resultado vazio legítimo. Uma reunião pode não ter tarefas confirmadas. Isso é diferente de uma resposta vazia porque a consulta não encontrou a gravação. Se ambos forem tratados como sucesso, a equipa pode acreditar que o processo terminou corretamente quando ficou informação por recuperar.
Escreve uma frase de sucesso antes de configurar notificações: “Existe um rascunho revisto quanto à identidade da reunião e pronto para conferência humana.” Depois descreve as condições que impedem esse resultado. O guia sobre testar um workflow antes de o ativar ajuda a transformar essas condições em casos de teste.
Escolhe o responsável e o canal do alerta
Um aviso só é operacionalmente útil quando tem um destinatário adequado e uma ação esperada. Define quem acompanha o processo, onde recebe a notificação e como regista que começou a investigar. Ajusta a urgência ao impacto da falha, para que problemas diferentes não produzam todos o mesmo ruído na equipa.
No exemplo da reunião, podes atribuir a investigação à pessoa responsável pela automação. Quem conduziu a reunião pode precisar de saber que o rascunho está atrasado, mas não necessita de receber detalhes técnicos ou dados completos da execução. São mensagens com destinatários e finalidades diferentes.
Escolhe um canal que essa pessoa consulte durante o período em que o processo importa. Um email pode chegar tecnicamente e ficar por ler. Uma mensagem num canal coletivo pode ser vista por várias pessoas sem que nenhuma assuma a resposta. Define explicitamente quem acompanha cada tipo de ocorrência.
Não precisas de alarmar toda a equipa por uma tentativa temporariamente falhada que foi recuperada e verificada. Mas uma sequência de falhas, um pedido parado ou um resultado incerto pode justificar intervenção. Documenta a condição que transforma uma ocorrência técnica num aviso de trabalho pendente.
Regista um contacto alternativo ou um procedimento para ausências. O objetivo é evitar que o conhecimento fique preso à pessoa que construiu o fluxo. Um pequeno registo com responsável, canal, horário de acompanhamento e próximo passo já torna a resposta mais clara.
Liga um workflow de erro no n8n
No n8n, podes criar um workflow dedicado a tratar falhas e associá-lo aos workflows que queres acompanhar. Este percurso permite separar a operação principal da preparação do aviso. Antes de o usar, confirma a configuração na tua versão e prepara um ambiente de teste com dados sintéticos e um destino controlado.
A documentação indica o seguinte percurso: cria um workflow com Error Trigger como primeiro nó, dá-lhe um nome e guarda-o. No workflow principal, abre as definições e seleciona esse fluxo em Error workflow. Podes reutilizar o mesmo tratamento em vários workflows. Consulta o guia de tratamento de erros do n8n, verificado em 14 de outubro de 2026.
Depois do gatilho, prepara uma mensagem curta e liga o canal autorizado que vais usar. No exercício, o nome “Alertas das reuniões” ajuda a perceber a função do workflow. Usa um destinatário de teste e confirma a conta associada ao nó que envia a notificação.
Há um detalhe importante: o workflow com Error Trigger não precisa de ser publicado para esta função, mas o gatilho só reage a falhas de execuções automáticas. Executar manualmente o workflow principal não testa esse percurso de erro. A documentação do Error Trigger explicita esta diferença.
Por isso, planeia um evento automático controlado para o teste. Não atives um processo com destinatários reais apenas para observar um erro. A configuração deve manter os efeitos limitados ao ambiente e ao caso que estás a validar, incluindo as mensagens produzidas pelo próprio alerta.
Prepara uma mensagem que permita começar a investigar
O aviso deve identificar o processo, o momento e a etapa afetada, com uma ligação para investigação quando ela estiver disponível. Acrescenta o efeito esperado que ficou pendente e o próximo passo recomendado. Evita copiar toda a entrada da automação, porque normalmente isso acrescenta ruído e pode expor informação que o destinatário não precisa.
Uma proposta de mensagem para o exercício seria: “O workflow de rascunhos de reunião não concluiu a consulta do resumo. Ocorrência de teste R-041. Verifica a identidade da reunião e o acesso à fonte antes de repetir. O estado do rascunho deve ser confirmado no destino.” Este texto é um exemplo editorial, não um alerta realmente enviado.
| Campo do aviso | Para que serve | Cuidados de revisão |
|---|---|---|
| Nome do workflow | Identificar o processo afetado | Evitar nomes genéricos como teste final |
| Momento da ocorrência | Localizar a tentativa | Indicar o fuso usado |
| Etapa e erro resumido | Começar o diagnóstico | Não apresentar uma hipótese como causa confirmada |
| Referência da ocorrência | Ligar aviso, investigação e resolução | Usar uma identidade estável e sem dados pessoais |
| Ligação à execução | Abrir os detalhes autorizados | Prever ausência e confirmar permissões |
| Estado e próxima ação | Evitar repetição precipitada | Distinguir falha confirmada de resultado incerto |
O conteúdo recebido pelo Error Trigger pode variar. A documentação indica que o identificador e a ligação da execução dependem do registo dessa execução e podem faltar em erros do gatilho principal. Nesses casos, o conteúdo inclui informação de gatilho com uma estrutura diferente. Não construas a mensagem assumindo que todos os campos existem sempre.
Testa o aviso com campos ausentes. Se a preparação da mensagem falhar porque não existe uma ligação, perdes a notificação precisamente quando precisas dela. Usa uma alternativa legível, como “execução sem ligação disponível”, e conserva o nome do processo e o erro que consegues identificar.
Torna explícitas as falhas que o sistema não reconhece sozinho
Algumas situações são tecnicamente válidas para a ferramenta e continuam a ser inválidas para o teu processo. Um campo obrigatório pode estar vazio ou uma resposta pode referir o registo errado. Define essas condições perto da etapa relevante e decide se o fluxo deve parar, pedir revisão ou seguir por um percurso de exceção.
No exemplo, receber uma resposta da API não basta. Precisas de confirmar que o resumo corresponde ao identificador da reunião esperada. Se essa correspondência não puder ser estabelecida, o fluxo não deve preparar um rascunho como se o conteúdo estivesse validado.
O nó Stop And Error permite provocar uma falha com uma mensagem ou objeto de erro quando se verifica uma condição definida. Pode ser usado para tornar explícita uma situação que exige interrupção. A documentação descreve as operações em Stop And Error, consultada em 14 de outubro de 2026.
Escolhe mensagens que indiquem o problema observado. “Identificador da reunião ausente” é mais útil do que “erro desconhecido”. Se ainda não sabes por que razão a consulta foi recusada, não escrevas que a credencial expirou. Essa pode ser uma hipótese a verificar, não uma conclusão já demonstrada.
Revê também os percursos que continuam depois de um erro tratado. Se convertes uma falha numa saída normal, define como ela ficará visível para acompanhamento. O estado final deve preservar o facto de que uma parte do trabalho ficou pendente, mesmo que outras etapas tenham sido concluídas.
Testa a receção e o percurso de resposta
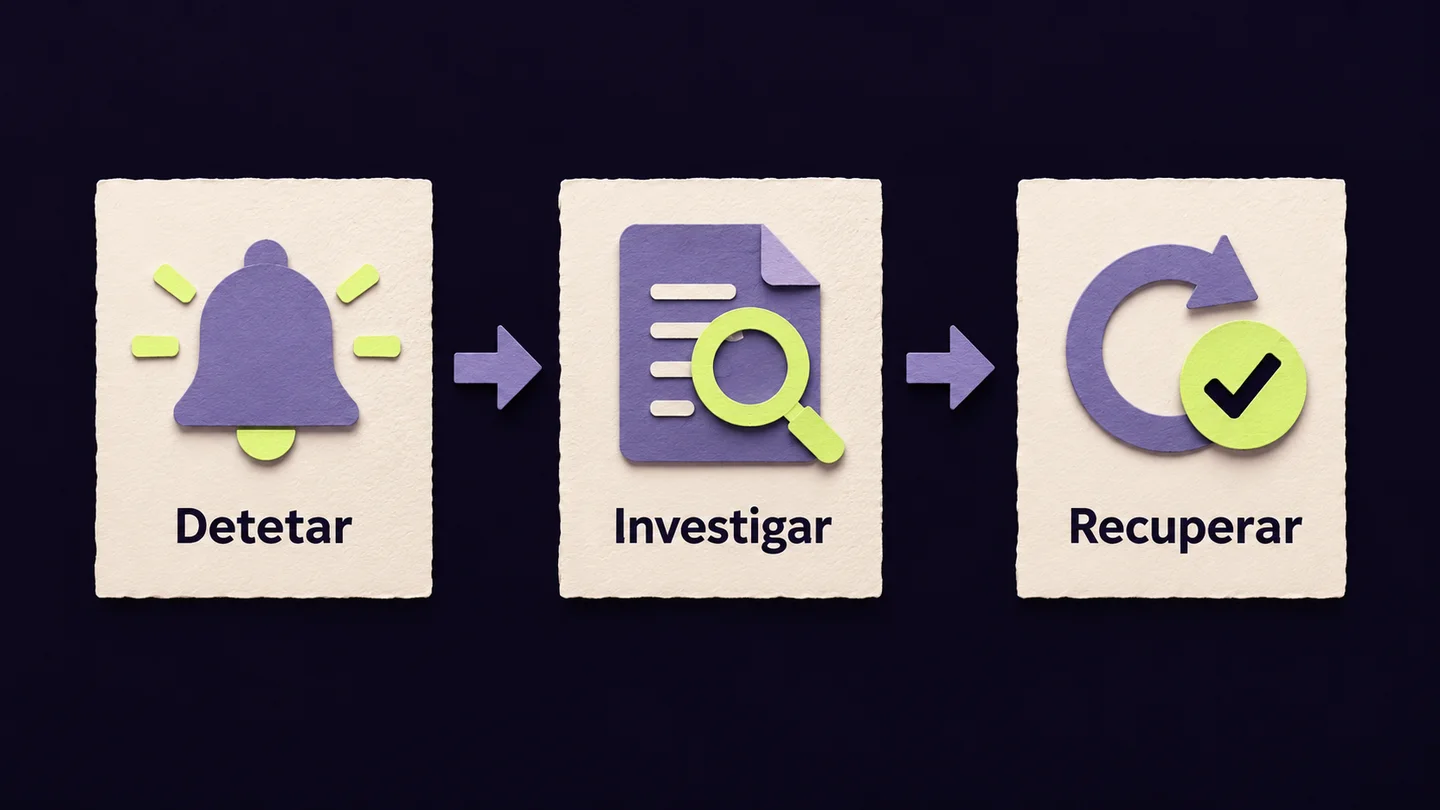
O teste deve confirmar que a falha é detetada, que a mensagem chega ao destino e que a pessoa consegue investigar com a informação recebida. Usa casos controlados e regista o resultado esperado antes de executar. Uma configuração guardada ou um nó com marca de sucesso não demonstra, por si só, que o alerta ficou utilizável.
Começa por um identificador ausente, que o teu fluxo deve reconhecer antes da consulta. Depois testa uma referência sintética inacessível no ambiente de teste. Confirma que os avisos distinguem os dois problemas e que nenhum deles inclui o conteúdo de uma reunião real.
Abre a notificação na conta de destino. Verifica assunto, corpo, ligação e permissões. Uma ligação que apenas o criador da automação consegue abrir pode ser insuficiente para o responsável de acompanhamento. Ajusta os acessos pelo processo autorizado, sem partilhar credenciais na mensagem.
Inclui um teste ao próprio canal de aviso. Se o envio da notificação falhar, como vais saber? Podes precisar de uma verificação independente ou de uma consulta periódica aos registos. Não assumes que o mesmo mecanismo avisa sempre da sua própria indisponibilidade.
Regista três momentos: falha detetada, aviso recebido e investigação assumida. São etapas distintas. Este registo ajuda a perceber se um atraso veio da automação, da entrega da notificação ou da organização da resposta, sem atribuir tudo ao mesmo problema.
Para uma automação agendada, considera ainda a ausência de execução. Se o sistema estiver parado, pode não existir uma falha registada no workflow. Uma verificação externa da execução esperada ou do resultado diário cobre uma situação diferente daquela que o Error Trigger acompanha.
Recupera sem repetir efeitos já realizados
Antes de repetir uma execução, verifica o que aconteceu no destino. Uma falha pode surgir depois de uma escrita ou de um envio ter sido aceite, deixando a confirmação incompleta. A recuperação deve retomar o trabalho necessário e preservar o que já foi realizado, com um registo que permita explicar a decisão tomada.
No nosso exemplo, pode ter sido criado um rascunho antes de a execução perder a confirmação. Repetir todo o fluxo sem procurar esse rascunho pode criar uma cópia. Usa a identidade da reunião e, quando disponível, o identificador do resultado para reconciliar o estado.
Distingue “não foi criado” de “não sei se foi criado”. O segundo caso pede investigação. Essa diferença deve aparecer no aviso e no procedimento de recuperação, para que a pessoa responsável não interprete qualquer erro como autorização para repetir todas as ações.
O guia sobre como evitar registos duplicados numa automação explica como relacionar eventos e efeitos. Para seguir a falha até à etapa concreta, mantém também um desenho claro do processo, como no guia sobre desenhar uma automação antes de abrir o n8n.
Depois da recuperação, confirma o resultado esperado e fecha a ocorrência. Regista o que falhou, o que foi corrigido e o que ficou verificado. Se a mesma situação voltar a acontecer, esse histórico ajuda a distinguir um problema recorrente de uma nova causa.
Mantém os alertas úteis ao longo do tempo
Um sistema de alertas precisa de revisão quando mudam os workflows, os responsáveis ou os canais. Acompanha notificações repetidas, ocorrências sem resposta e falhas que só foram descobertas por acaso. Usa essa informação para ajustar o contexto e a prioridade dos avisos, mantendo uma forma simples de verificar que o acompanhamento continua a funcionar.
Se várias tentativas pertencem à mesma ocorrência, pode fazer sentido agrupá-las e mostrar o número de repetições. Preserva os detalhes necessários para investigar, mas evita tratar cada tentativa como um incidente independente. Define quando um novo efeito ou uma nova entidade exige uma ocorrência separada.
Confere a retenção dos registos na tua instalação. Uma ligação antiga pode deixar de mostrar os dados necessários. Guarda um resumo operacional suficiente para aprender com o problema, respeitando os acessos e evitando conservar dados completos de clientes sem necessidade.
Revê o procedimento com outra pessoa da equipa. Ela deve conseguir compreender o aviso, localizar a ocorrência e saber quando pode retomar o processo. Se precisa de adivinhar quais os passos seguros, melhora a documentação e volta a testar o percurso antes de depender dele.
Como podes aprender isto no Laboratório da IA
No Laboratório da IA podes aprender a construir automações com critérios de resultado, diagnóstico e recuperação. As aulas semanais e os Zooms de acompanhamento semanais ajudam-te a trabalhar sobre situações concretas, perceber onde um fluxo falhou e preparar testes que confirmem o efeito no destino antes de o colocares em uso.
Traz um processo pequeno, uma falha observada e uma amostra sem dados sensíveis. Podes praticar a definição do alerta, a leitura das execuções e a recuperação, para que a automação tenha acompanhamento e um responsável que saiba o que fazer quando algo fica pendente.
Referências
As referências oficiais seguintes foram consultadas em 14 de outubro de 2026 para confirmar o tratamento de erros no n8n. O workflow de rascunhos e a ocorrência R-041 são exemplos fictícios. Não foram enviadas notificações, consultadas reuniões ou executadas integrações como prova deste artigo; os testes descritos são um percurso proposto.
Aprende a construir isto no Lab.
Trabalha o processo com aulas, materiais e acompanhamento. Leva o que estás a construir e esclarece as dúvidas da tua implementação.
- Distinguir erro de execução, resultado incorreto e execução ausente.
- Preparar alertas com contexto e um procedimento de recuperação.
- Praticar automações nas aulas e Zooms semanais do Lab.
Aulas semanais para aprender e aplicar. Zooms de acompanhamento semanais para esclarecer dúvidas. Replay e materiais para retomar o trabalho ao teu ritmo.
Entrar no Laboratório da IA